分类: 默认

  • 在Openshift中配置Selenium-Grid

    在Openshift中配置Selenium-Grid

    通过Selenium-Grid我们可以使用一个更灵活的环境,同时还能得到在不同机器的不同浏览器上执行测试的功能。

    Selenium-Grid由一个中心(Hub)和一到多个节点(Node)组成。两者都是通过 selenium-server.jar 启动。如果是手动安装需要先启动Hub,然后再启动Node,Node会通过启动时的配置连接注册到Hub中。

    Docker明显是一个更好的选择,使用这个docker-compose就可以快速启动一个拥有两个节点的Grid。

    hub:
      image: selenium/hub
      ports:
        - "4444:4444"
    firefox:
      image: selenium/node-firefox
      links:
        - hub
    chrome:
      image: selenium/node-chrome
      links:
        - hub

    Docker自然是方便,但是因为有Openshift,所以更希望直接在Openshift上启动一个Grid。这里就需要额外的yaml文件来办了。

    从Github上找到两个可以用的,这是Hub

    apiVersion: v1
    kind: Template
    metadata:
      name: selenium-hub
      annotations:
        description: "A Selenium Grid"
        iconClass: "icon-selenium"
        tags: 
  • Heroku和国内的PAAS服务商

    写完这篇博客,发现一个问题,这里比较的其实本质是App engine而不是PAAS平台。相对的其实应该是Azure的App Service,AWS的AWS Elastic Beanstalk。

    有很多应用目前是放在Heroku上的。Heroku的功能自然没得说,好用简单,各种第三方服务可以很轻易的集成。但是Heroku从中国大陆访问问题很严重,基本处于不可访问的状态,所以就需要找个国内的类似的服务商或者外国服务商但是从中国大陆访问速度可以接受的。

    Paas这种生意一般都是大厂在做,然后比较一番,其实也没有多少,阿里云之前有个ACE后面死掉了,AWS中国还在测试,京东容器服务也是在内侧中,算来算去,功能上和Heroku接近的只有百度云应用引擎,新浪SAE。

    我关注的点主要在于代码能否自动构建,支持语言,绑定域名和价格

    名称 代码自动构建 Java Python Node 绑定域名 价格(Java 512M) 数据库 其他第三方服务
    Heroku 支持 支持 支持 支持 支持 35 支持
    百度云应用引擎 不支持 支持 支持 支持 支持 21 支持 基本没有
    新浪SAE 不支持 支持 支持
  • Cloud Foundry的buildpack结构

    Cloud Foundry的buildpack结构

    Buildpack是Cloud Foundry中一个很基本的组件。它意在为应用提供框架和运行环境的支持。也就是说当你上传内容物到Cloud Foundry上时,会根据Buildpack的内容为你准备必要的基本内容物来支持你的应用。

    一个Buildpack通常要包括以下三个关键步骤:

    1. 检测
    2. 编译
    3. 发布

    其中的检测步骤主要是判断当前上传的内容物是否可以使用当前的buildpack处理,一般情况下检测可以很简单,比如一个gradle-java-buildpack就可以检测当前目录是否包含build.gradle文件。

    #!/usr/bin/env bash
    # bin/detect <build-dir>
    
    elif [ -f $1/build.gradle ]; then
      echo "Gradle" && exit 0
    
    else
      echo "no" && exit 1
    fi

    编译步骤主要是准备必要的依赖和环境,这里就要分两种情况了,就是编译是否真正发生。如果上传的内容物是一个jar,那就只需要提供jre就行了,如果上传的内容物是源代码,那就是需要jdk环境,并且执行必要的编译打包步骤,最后在提取运行包。

    具体使用哪种情况主要看对于Cloud Foundry的使用偏好,我是比较喜欢在Cloud Foundry直接编译的。

    一般情况下这一步会比较耗时,以java项目为例,下载一个jdk或者jre是必要的,为了节约时间,Cloud Foundry会在这一步提供一个缓存目录以供使用。

    最后一步是发布,这一步必须生成一个YAML文件,里面是必要的运行命令。

    类似于:

    default_process_types:
      
  • 快速生成.gitignore文件

    快速生成.gitignore文件

    当新启动一个项目的时候,特别是项目会托管到GIT仓库的时候我们一般会选择添加.gitignore文件。

    gitignore可以手动添加,但是随着语言,IDE工具,框架的变动,创建.gitignore也越发复杂了,经常会漏掉一些东西。

    这里有一个网站可以帮助生成gitignore文件: https://www.gitignore.io/


  • sited(多多猫)插件开发

    最近看漫画有点多,因为各种各样的原因各个网站的漫画都不全,好不容易找到一个好用的,估计服务器不在大陆,速度特别慢。但是又只有网页版本,自然没有各种缓存,离线 下载功能了。

    本来寻思自己写一个,但是在知乎看到一个推荐多多猫的,就简单尝试了一下,果然不要自己造轮子呀。

    多多猫这个app本身是没有任何内容的,它只是一个插件容器,内容来源是需要插件实现的。而插件的标准(?)名为sited,是xml格式,具体代码实现是javascript。简单来说文档是有的,而且只找到了一份官方的,可以看出有些内容并没有及时更新,但是照着做一个还是没有问题的。

    简单来说一下这个漫画网站的结构,主页就是一个列表,每个漫画有分页,一页10张图,一般一个漫画200张左右,就是一个没有目录结构的顺序图集。

    先来看看插件大体格式

    <?xml version="1.0" encoding="utf-8"?>
    <sited ver="1" debug="0" engine="32" schema="1">
        <meta>
            <title>XXX漫画</title>
            <encode>utf-8</encode>
            <ua>Mozilla/5.0 (Windows NT 6.3; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/56.0.2924.87
                Safari/537.36
            </ua>
        </meta>
        <main dtype="4" durl="xxx">
            <home>
                <hots cache="10m" title="首页" method="get" parse="hots_parse" url="xxx" 
  • BT种子文件转二维码

    自从入手小米路由器以来,下载电影就只选择最大的了,因为路由器下载可以在白天上班时间下载,而且夜间也可以,下载完成还可以用手机或者电视播放。

    小米路由器APP端支持扫码下载和手动添加任务,当然手机上添加BT种子挺麻烦的,所以我一般用扫描二维码,好在很多下载站都提供了二维码。二维码中一般是种子的下载地址或者磁力链。但是偶尔会遇到只有种子文件的情况,所以就需要想个办法来转化成为二维码。

    最终效果在这里:https://to-qr.herokuapp.com/

    简单的地方就跳过了,比如如何上传文件,显示二维码这些,这里只关注两个问题。

    1. BT文件转磁力链接
    2. 磁力链接转二维码

    BT文件转磁力链接

    磁力链接中最关键的内容就是info hash,这个值可以轻松从BT文件中解析。

    具体原理可以参考BT种子文件结构。这里使用ttorrent-core库。

    package com.huangyunkun.service;
    
    import com.turn.ttorrent.common.Torrent;
    import org.apache.commons.io.FileUtils;
    import org.springframework.stereotype.Service;
    
    import java.io.File;
    import java.io.IOException;
    import java.security.NoSuchAlgorithmException;
    
    @Service
    public class TorrentService {
        public String getLink(File file) throws IOException, NoSuchAlgorithmException {
            Torrent torrent = 
  • 使用onelogin快速集成Okta SSO

    使用onelogin快速集成Okta SSO

    Okta是专业的身份管理平台,它是以整合的思路管理企业应用和资源。

    如果企业有一个内部应用需要认证后使用,那么Okta提供的单点登录功能就是一个很好的集成点。集成Okta可以将用户认证部分从应用剥离,使用者还是可以使用Okta的信息登录,并且应用也能获得对应的信息。

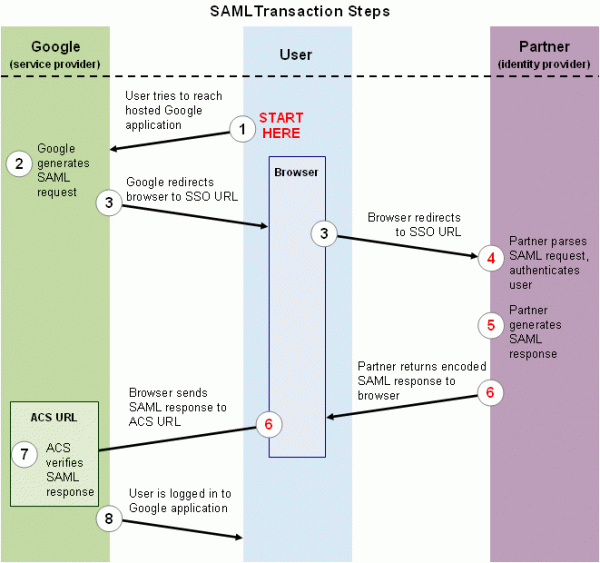
    本文选用的是通过SAML协议集成Okta。SAML即安全断言标记语言,英文全称是Security Assertion Markup Language。 它是一个基于XML的标准,用于在不同的安全域(security domain)之间交换认证和授权数据。

    来个示意图:

    从图中可以看到集成部分从收到Response之后应用就获得用户的信息(比如Name ID),之后的事情就是应用自己的了。

    Saml毕竟是一个标准协议,直接使用公开的库就行了。OpenSaml本来是最合适的,但是使用有些麻烦,最后选择的是onelogin的java-saml库。

    必要的配置只有五个

    onelogin.saml2.sp.entityid
    onelogin.saml2.sp.assertion_consumer_service.url
    onelogin.saml2.idp.entityid
    onelogin.saml2.idp.single_sign_on_service.url
    onelogin.saml2.idp.x509cert

    这个在Okta的配置页面就有。

    一般应用程序需要提供两个功能点,一个是GET方法检测是否需要进入SSO流程,一个是POST方法用于接收Saml的返回断言。

    @GET
        public Response showLoginPage(@Context HttpServletResponse response,
                                      @Context HttpServletRequest request) throws Exception {
            Auth auth = new Auth(request, response);
            auth.login();
            return 
  • JDBC的MySQL连接字符串

    JDBC的MySQL连接字符串

    今天迁移一个应用,放在heroku死活没法运行。仔细对比以后发现heroku会暴露名为JDBC_DATABASE_URL的环境变量,而这个环境变量只有一个默认参数reconnection=true。

    而原应用运行环境中还多了两个参数,一个是allowMultiQueries 和zeroDateTimeBehavior 。最开始没有太在意,想着应用很简单,无非就是影响一下性能而已,结果直接无法运行,被迫加上。

    来看看这两个参数,第一个allowMultiQueries 是运行一次运行多行。多行是指命令层级的含义,比如select ‘hello’;select ‘world’ 。

    第二个zeroDateTimeBehavior 是对于时间的处理,比如有一个条插入语句,没有提供需要的时间时,默认情况会抛出

    Cannot convert value '0000-00-00 00:00:00' from column 7 to TIMESTAMP

    这时候将zeroDateTimeBehavior 指定为convertToNull可以避免写入错误的值。…

  • Splunk使用的一些小窍门

    Splunk可以用作日志分析工具,之前只是简单的把它当作日志搜集工具并没有其他用。

    突然有一个很冷门的小应用,在线上运行了好几年,它使用的AWS SNS推送服务,推送服务是针对邮编的,现在想知道每个邮编每月的发送量。

    首先看关键字,之前代码每发送一个信息会打一条日志Published message: xxxx to customer-alert-61000,最后那个是邮编。

    首先提取自定义字段

    rex field=_raw "customer-alert-(?<postcode>.*)"

    作用就是匹配正则,并把匹配的内容作为新的field,名为postcode。

    然后规定时间长度为

    timechart span=1mon count

    最后以postcode为分组依据

    timechart span=1mon count by postcode

    Splunk对于分组会默认有一个限制,超过限制的部分会命名为Others,显然我们不需要Others,而是需要所有分组,邮编有超过两千个,直接粗暴一些,禁用others,然后最大长度限制为3000

    useother=f limit=3000

     …

  • 全站开启https

    申请了一个StartSSL的证书把全站https开启了,刚刚弄好,突然看到一条新闻说StartSSL证书有问题,一些基金会要移除它的根证书。

    只有赶紧换一套证书,看了一下let’s encrypt比较简单,马上本地安装let’s encrypt客户端,十秒获得全套证书,当然还有续期的问题,不过这个可以后面处理。

    具体的配置直接使用Mozilla SSL Configuration Generator生成一个,然后ssllabs的分析器测试一下。

    ssl

     …