月度归档: 2015 年 5 月

  • Spark中的梯度下降

    Spark中的梯度下降

    梯度下降是一个最优化算法,通常也称为最速下降。
    梯度下降是求解无约束优化问题最简单和最古老的方法之一,许多有效算法都是以它为基础进行改进和修正而得到的。

    最速下降是用负梯度方向为搜索方向的,最速下降法越接近目标值,步长越小,前进越慢。

    虽然古老而简单,但是很多时候依然可以将它用在一些情况中,也很适合快速入门。

    Spark中的优化组件

    Spark中的MLlib下的optimization包含了梯度下降的相关组件。

    从数理基础和很多改进算法来看,梯度下降的主要抽象集中在两个方面,即如何度量梯度和如何更新参数。

    Spark中的梯度抽象为Gradient.scala

    abstractclass Gradient extends Serializable {
    def compute(data: Vector, label: Double, weights: Vector): (Vector, Double) = {
    val gradient = Vectors.zeros(weights.size)
    val loss = compute(data, label, weights, gradient)
    (gradient, loss)
    }
    
    def compute(data: 
    …
  • Spark中的ML Pipelines

    Spark中的ML Pipelines

    Spark生态圈中有一个MLlib,其目标在于使机器学习更加简单和可扩展。
    MLlib的开发非常活跃,其中添加新的算法和提升性能是一个主要的方向,而另一个方面是让MLlib更简单。

    和Spark Core类似,MLlib提供了三种语言用API:Scala,Java和Python。用户可以根据文档和例子开始使用相应的功能,但是由于用户的技术和知识背景不同,学习曲线各不相同。为了让MLlib更好用,Spark 1.2开始引入了ML Pipeline API。

    一个常见的机器学习流程包含了序列数据的预处理,特征提取,模型拟合和验证等。

    以文本分类为例,包含了文本切割,文本清理,特征提取,训练分类模型和交叉检验。
    虽然对于其中的每一个步,都有很多可以选用的第三方库来完成,但是将它们结合起来一起使用却不是那么简单。

    很多库的API外观迥异,而且并没有为分布式数据处理提供支持。

    Spark的ML Pipelines要做的就是从抽象层开始让机器学习更简单(不论是使用Spark以后的算法还是自己实现)。

    数据抽象

    在整体设计中,数据集的表现通过DataFrame来完成。DataFrame是Spark SQL中的组件。

    除了单纯的数据源以外,还有一个或者多个转化器将数据转化后置入Spark甬道中。

    转化器获取到输入数据并给出输出数据,输出数据又会成为下一个步骤的输入数据。
    直接选用Spark SQL中的组件主要是考虑到了数据的输入输出,灵活的数据列类型操作和优化问题。

    数据的输入输出是一个甬道的开始或者结束。
    目前提供的输入输出包含了

    • LabeledPoint (分类和回归)
    • Rating (协同过滤)
    • 等等

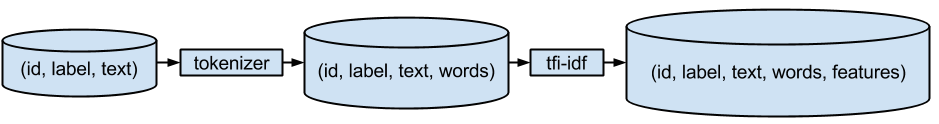
    特征转化是一个甬道中的重要部分,比如将文本转为词序列,对词做TF-IDF变化等。

    甬道示例

    甬道

    ML Pipelines相关内容都在spark.ml包下。

    一个甬道包含了多个步骤,最基本的包含转化和评估。

    转化就是上文提到的将文本转为词序列等等,评估更多的是训练对应的模型。

    创建甬道:

    Tokenizer tokenizer =new Tokenizer()
    .setInputCol("text")
    .setOutputCol("words");
    
    …
  • 使用Gradle注册SpringXD的module

    使用Gradle注册SpringXD的module

    SpringXD是Pivotal的大数据产品,提供了一个抽象的数据处理平台。

    SpringXD将数据解决方案抽象为数据吸纳,分析,流调度和输出四大块。

    作为源头的数据吸纳可以从各种数据源中获取需要的数据,基于Spring的另外一个项目spring-integration,这一部分的大部分实现都可以使用简单的dsl实现。

    在SpringXD中每一个部分的组件都可以自己编写并注册到服务中,方便之后的使用。

    但是在编写阶段每次都需要打包,上传服务器,然后注册,整个过程还是有点繁琐的。

    Gradle作为一个构建工具,自然可以通过自定义任务完成这个任务。

    微博数据吸纳

    这里以微博的数据源为例。

    微博的数据源因为新浪微博提供了sdk,所以自己编写稍微方便一些。

    SpringXD项目默认也提供了twitter的两个source方便测试。

    先看一下build.gradle的配置

    ext {
    xdVersion ='1.1.1.RELEASE'
    springVersion ='4.1.3.RELEASE'
    moduleType ='source'
    moduleName ='weibo'
    xdServer ="http://192.168.0.12:9393"
    version ='0.0.1-SNAPSHOT'
    }

    最关键的配置变量是moduleType,moduleName和xdServer。

    为了简单明了,WeiboSource并不具有配置参数(一般情况下都需要提供一些配置参数的,比如apiKey),主配置文件如下

    <?xml version="1.0" encoding="UTF-8"?>
    <beans:beans xmlns="http://www.springframework.org/schema/integration"
    xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
    xmlns:beans="http://www.springframework.org/schema/beans"
    xsi:schemaLocation="http://www.springframework.org/schema/integration http://www.springframework.org/schema/integration/spring-integration.xsd
    http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans.xsd">
    
    <channel 
    …